Décryptages
Synchronisation labiale en anime IA : comment nous associons les voix ElevenLabs à MiniMax H3
Animey double d’abord chaque réplique avec la voix ElevenLabs du personnage, laisse MiniMax H3 animer le plan et dire la réplique, puis pose la réplique doublée exacte là où les bouches ont bougé. Les mots entendus sont toujours le script approuvé dans la voix choisie, tandis que les lèvres suivent une véritable interprétation et non un doublage plaqué après coup.
Par l’équipe Animey6 min de lecture
C’est sur le dialogue que l’anime par IA se casse le plus souvent la figure : le bon visage dit les mauvais mots, ou les mots sont justes et la bouche continue de bouger après la réplique. Cet article montre les trois approches que nous avons testées sur une seule réplique, et celle qu’utilise Animey, un studio d’anime par IA de Softforge Digital, pour les épisodes scénarisés, en octobre 2026.
Le plan et la réplique
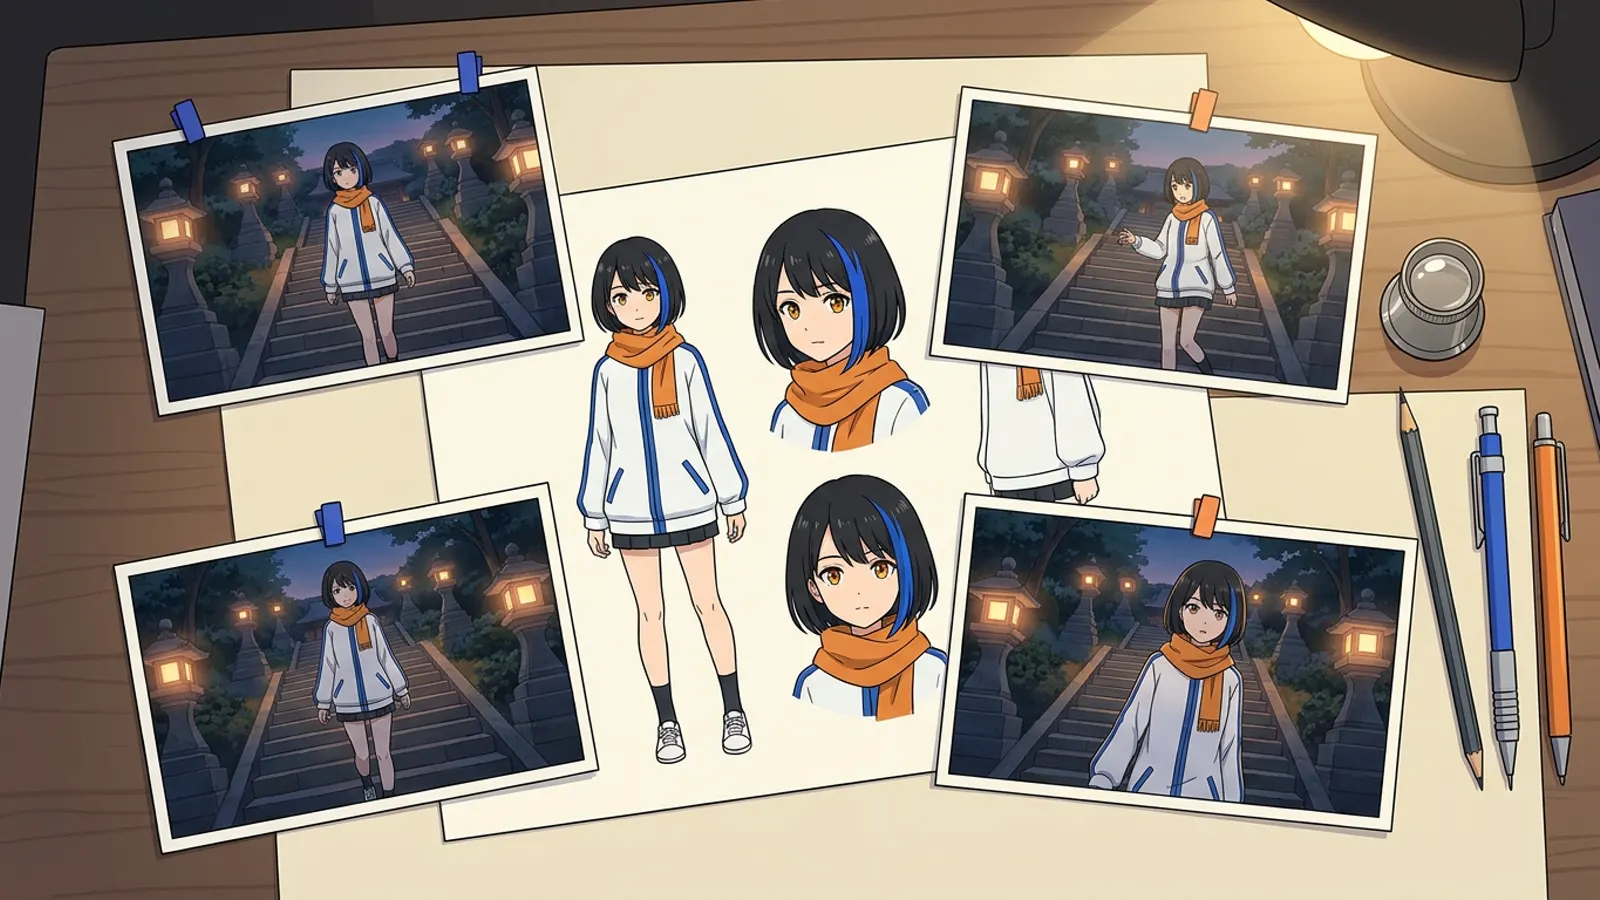
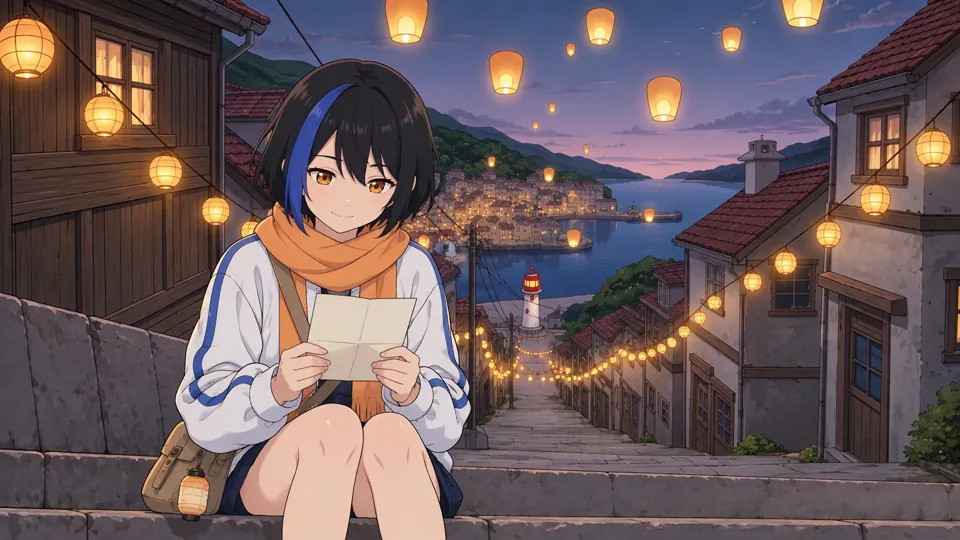
Une image clé tirée de notre test des modèles d’image : Mira sur l’escalier éclairé de lanternes, une lettre à la main. Une réplique, doublée avec ElevenLabs Multilingual v2 : « C’est de Grand-père… Il s’en est souvenu. » La réplique doublée dure 2,5 secondes ; le plan en dure 5.
Prise 1 : le modèle vidéo parle de lui-même
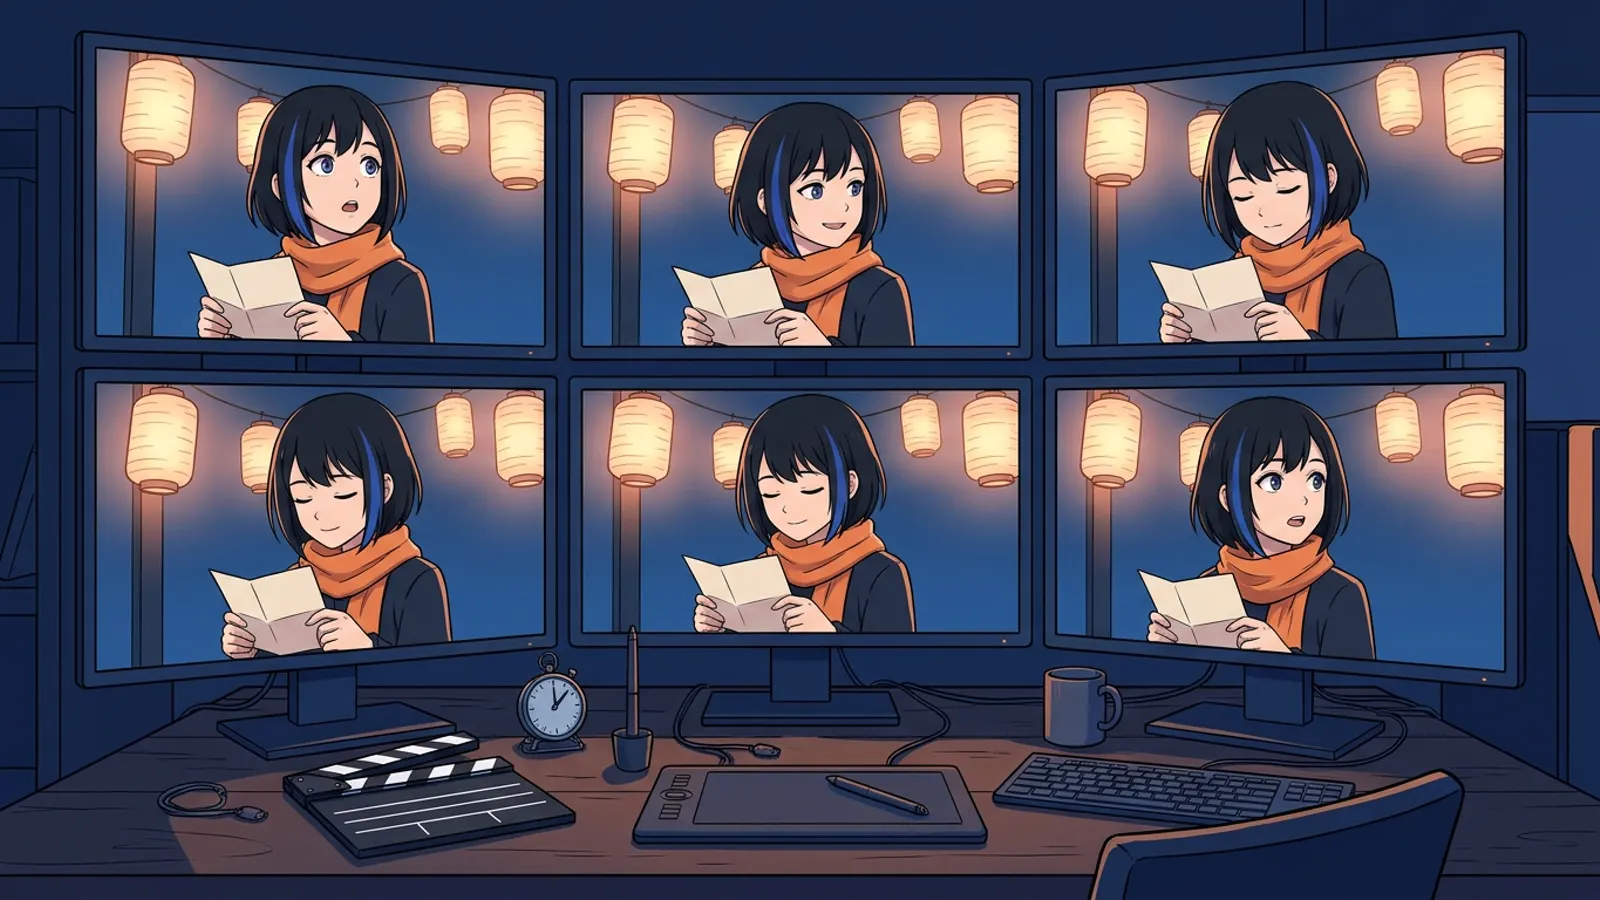
MiniMax H3 Max peut générer le son avec l’image. Nous lui avons demandé de dire la réplique, et seulement la réplique, en deux parties. L’animation est bonne et la bouche bouge en rythme avec la parole, parce que le même modèle a produit les deux.
Le problème, c’est tout ce qui entoure les lèvres. La voix est celle que le modèle a choisie pour ce clip, si bien que le plan suivant peut sembler dit par quelqu’un d’autre. Et rien ne garantit les mots : en bêta, une prise a dit sa réplique puis a continué avec des mots inventés. Pour un clip isolé, c’est une curiosité ; pour une série, cela casse le personnage.
Prise 2 : la réplique exacte posée sur les bouches
La solution évidente consiste à donner notre audio au modèle vidéo pour qu’il anime les lèvres dessus. Nous avons essayé, et l’entrée audio du modèle que nous utilisons n’a fait que remplacer la bande son : les bouches bougeaient toujours d’après le texte, et continuaient après la réplique. Animey procède donc dans l’autre sens, dans un mode que nous appelons Script strict.
- Doubler chaque réplique d’abord. Avant toute animation, chaque réplique est doublée avec la voix choisie pour le personnage qui parle, dans la langue de l’épisode, issue de notre bibliothèque ou conçue à partir d’une description. Animey ne clone jamais une voix réelle.
- Laisser le modèle parler dans des fenêtres de temps. MiniMax H3 anime le plan à partir de l’image clé approuvée et dit chaque réplique dans la fenêtre de temps dont la réplique doublée a besoin, si bien que les bouches s’ouvrent là où les mots se trouveront.
- Repérer les bouches, poser la réplique exacte. L’interprétation du modèle est transcrite. Chaque réplique doublée exacte est placée là où ses bouches l’ont dite, jouée à une vitesse de 0,8 à 1,25 fois pour remplir cet intervalle, et le son propre du modèle est écarté.
- Sous-titrer à partir du script. Les sous-titres sont le script lui-même, calés sur les mots doublés, si bien qu’ils ne peuvent jamais contredire ce que l’on entend.
La garantie est simple : dans une prise en Script strict, les mots que vous entendez sont le script approuvé, dans la voix du personnage, dans l’ordre, sans rien d’ajouté. Si le modèle a articulé un mot absent du script, cette bouche reste muette plutôt que de dire quelque chose de nouveau.
Prise 3 : la voix comme référence
Certains modèles acceptent l’audio comme référence plutôt que comme bande son. Seedance 2.0 accepte à la fois des images, des vidéos et de l’audio ; notre ancien niveau Référence lui envoyait l’image clé, les vues du personnage et la réplique doublée. Voici cette recette avec Seedance 2.0 Fast.
| Approche | Mots exacts | Même voix à chaque plan | Les lèvres suivent la parole |
|---|---|---|---|
| Le modèle parle de lui-même | Non garantis | Non | Oui |
| Réplique exacte posée sur les bouches du modèle (Script strict) | Oui | Oui | Oui, entre 0,8 et 1,25 fois la vitesse |
| La voix comme référence | Non garantis | Proche, pas identique | Oui |
Quand la voix propre du modèle est la bienvenue
Certains auteurs préfèrent l’interprétation du modèle : les respirations, les rires et l’ambiance viennent avec. C’est l’Interprétation native. Chaque prise est transcrite et comparée au script ; une prise qui ajoute, omet ou réordonne des mots est marquée comme non conforme et ne peut pas être sélectionnée. Si elle a dit tous les mots du script puis a continué de parler, la parole en trop peut être rendue muette gratuitement, grâce au minutage des mots de la prise elle-même.
Les voix elles-mêmes sont présentées dans donner une voix à un personnage, et le nombre de mots qui tiennent dans un plan de cinq secondes dans le guide du rythme.
Questions auxquelles cet article répond
- Comment synchroniser les lèvres sur les dialogues d’un anime par IA ?
- Animey double d’abord la réplique, laisse MiniMax H3 animer le plan et parler dans la fenêtre de temps de la réplique, transcrit l’endroit où les bouches ont parlé, et y pose la réplique doublée exacte à une vitesse de 0,8 à 1,25 fois, en écartant le son propre du modèle.
- Quel modèle de voix Animey utilise-t-il ?
- ElevenLabs. Les personnages utilisent des voix tirées d’une bibliothèque sélectionnée de voix d’IA sous licence, ou des voix conçues à partir d’une description écrite ; Multilingual v2 est le modèle par défaut et Eleven v3 prend en charge les dialectes arabes. Animey ne clone jamais la voix d’une personne réelle.
- Pourquoi ne pas laisser le modèle vidéo dire les dialogues ?
- C’est possible, en Interprétation native, mais le modèle choisit sa propre voix pour chaque clip et peut changer ou ajouter des mots. Animey vérifie chaque prise native par rapport au script, et le Script strict garantit les mots exacts dans la voix du personnage.
- Un modèle vidéo peut-il synchroniser les lèvres sur ma propre piste audio ?
- Certains acceptent l’audio, mais dans nos tests l’entrée audio soit remplaçait la bande son sans faire bouger les lèvres, soit servait de référence que le modèle réinterprétait. Poser la réplique exacte sur les mouvements de bouche du modèle lui-même a donné le résultat le plus fiable.
Lancez votre propre série
Décrivez votre univers, créez vos personnages et planifiez votre premier épisode, scène par scène.
Commencer gratuitement