Explicaciones
Sincronización labial en anime con IA: cómo combinamos voces de ElevenLabs con MiniMax H3
Animey pone voz primero a cada línea con la voz de ElevenLabs del propio personaje, deja que MiniMax H3 anime el plano y diga la línea, y después coloca la línea exacta con voz justo donde se movieron las bocas. Las palabras que se oyen son siempre el guion aprobado en la voz elegida, mientras que los labios siguen una interpretación real y no un doblaje añadido después.
Por el equipo de Animey6 min de lectura
El diálogo es donde el anime con IA se desmorona más a menudo: la cara correcta dice las palabras equivocadas, o las palabras son correctas y la boca sigue moviéndose después de la línea. Este artículo muestra los tres enfoques que probamos con una sola línea de diálogo y el que usa Animey, un estudio de anime con IA de Softforge Digital, para los episodios con guion, a octubre de 2026.
El plano y la línea
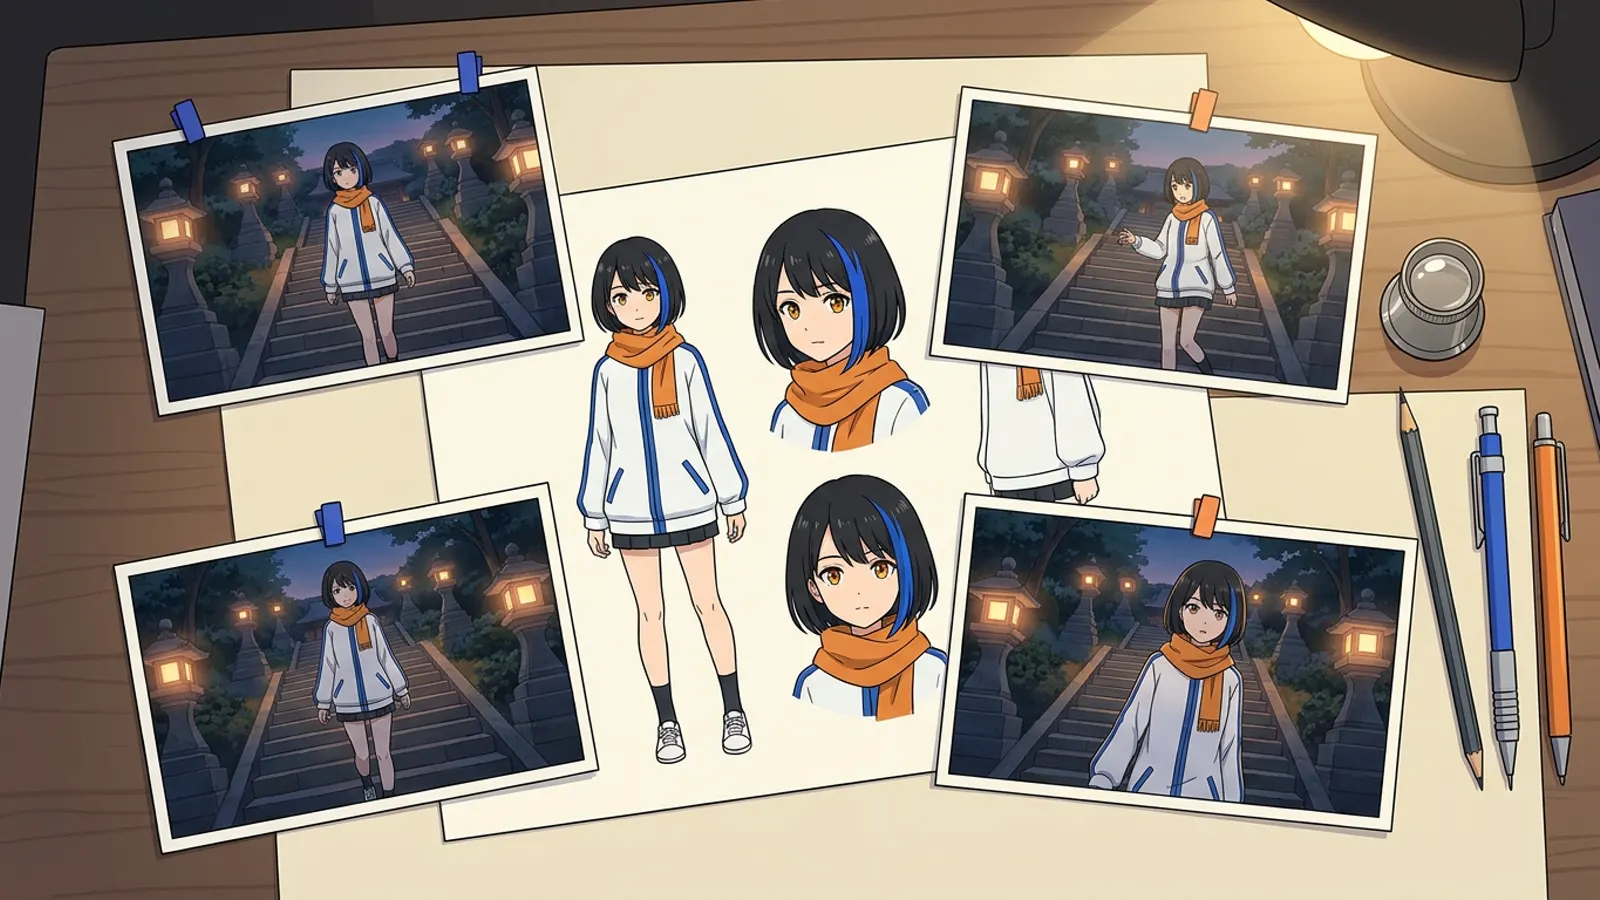
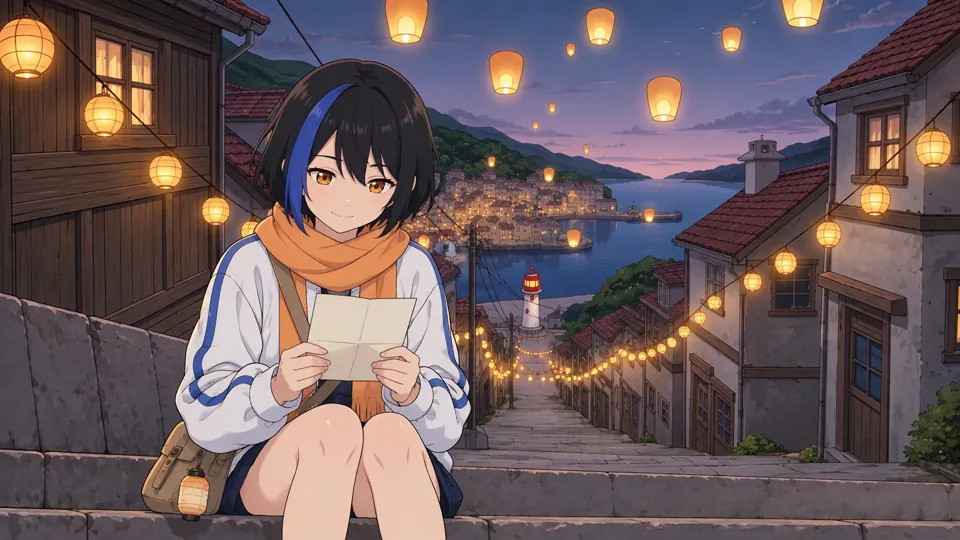
Un fotograma clave de nuestra prueba de modelos de imagen: Mira en la escalera iluminada por farolillos, con una carta en la mano. Una línea, con voz generada por ElevenLabs Multilingual v2: «Es del abuelo… Se acordó». La línea con voz dura 2.5 segundos; el plano, 5.
Toma 1: el modelo de vídeo habla por sí mismo
MiniMax H3 Max puede generar sonido junto con la imagen. Le pedimos que dijera la línea, y solo la línea, en dos partes. La animación es buena y la boca se mueve al ritmo del habla, porque el mismo modelo hizo las dos cosas.
El problema es todo lo que rodea a los labios. La voz es la que el modelo eligió para este clip, así que el plano siguiente puede sonar como otra persona. Y nada garantiza las palabras: en la beta, una toma dijo su línea y luego siguió con palabras inventadas. En un solo clip es una curiosidad; en una serie, rompe al personaje.
Toma 2: la línea exacta colocada sobre las bocas
La solución obvia es darle nuestro audio al modelo de vídeo y dejar que anime los labios a partir de él. Lo probamos, y la entrada de audio del modelo que usamos solo sustituyó la banda sonora: las bocas seguían moviéndose según el texto y continuaban después de la línea. Así que Animey lo hace al revés, en un modo que llamamos Guion estricto.
- Poner voz primero a cada línea. Antes de animar nada, cada línea se genera con la voz elegida para quien habla en el idioma del episodio, tomada de nuestra biblioteca o diseñada a partir de una descripción. Animey nunca clona una voz real.
- Dejar que el modelo hable dentro de ventanas de tiempo. MiniMax H3 anima el plano a partir del fotograma clave aprobado y dice cada línea dentro de la ventana de tiempo que necesita la línea con voz, para que las bocas se abran donde irán las palabras.
- Encontrar las bocas y colocar la línea exacta. La interpretación del modelo se transcribe. Cada línea exacta con voz se coloca donde sus bocas la dijeron, reproducida a una velocidad de 0.8 a 1.25 veces para llenar ese tramo, y el sonido propio del modelo se descarta.
- Subtitular a partir del guion. Los subtítulos son el propio guion, sincronizados con las palabras de la voz, así que nunca pueden contradecir lo que se oye.
La garantía es sencilla: en una toma de Guion estricto, las palabras que oyes son el guion aprobado en la voz del personaje, en orden y sin nada añadido. Si el modelo articuló una palabra que no está en el guion, esa boca se queda en silencio en lugar de decir algo nuevo.
Toma 3: la voz como referencia
Algunos modelos aceptan audio como referencia en lugar de como banda sonora. Seedance 2.0 admite imágenes, vídeos y audio a la vez; nuestro antiguo nivel Referencia le enviaba el fotograma clave, las vistas del personaje y la línea con voz. Esta es esa receta con Seedance 2.0 Fast.
| Enfoque | Palabras exactas | Misma voz en cada plano | Los labios siguen el habla |
|---|---|---|---|
| El modelo habla por sí mismo | No garantizadas | No | Sí |
| Línea exacta colocada sobre las bocas del modelo (Guion estricto) | Sí | Sí | Sí, entre 0.8 y 1.25 veces la velocidad |
| La voz como referencia | No garantizadas | Parecida, no idéntica | Sí |
Cuando la voz propia del modelo es bienvenida
Algunos autores prefieren la interpretación del modelo: las respiraciones, las risas y el ambiente vienen incluidos. Eso es la Interpretación nativa. Cada toma se transcribe y se compara con el guion; una toma que añade, omite o reordena palabras se marca como no coincidente y no se puede seleccionar. Si dijo todas las palabras del guion y luego siguió hablando, el habla sobrante se puede silenciar gratis a partir de los tiempos de las palabras de la propia toma.
Las voces en sí se explican en cómo dar voz a un personaje, y cuántas palabras caben en un plano de cinco segundos, en la guía de ritmo.
Preguntas que responde
- ¿Cómo se hace la sincronización labial de los diálogos en un anime con IA?
- Animey pone voz primero a la línea, deja que MiniMax H3 anime el plano y hable dentro de la ventana de tiempo de la línea, transcribe dónde hablaron las bocas y coloca allí la línea exacta con voz a una velocidad de 0.8 a 1.25 veces, descartando el sonido propio del modelo.
- ¿Qué modelo de voz usa Animey?
- ElevenLabs. Los personajes usan voces de una biblioteca seleccionada de voces de IA con licencia o voces diseñadas a partir de una descripción escrita; Multilingual v2 es el modelo por defecto y Eleven v3 se encarga de los dialectos árabes. Animey nunca clona la voz de una persona real.
- ¿Por qué no dejar que el modelo de vídeo diga los diálogos?
- Se puede, en Interpretación nativa, pero el modelo elige su propia voz en cada clip y puede cambiar o añadir palabras. Animey comprueba cada toma nativa con el guion, y el Guion estricto garantiza las palabras exactas en la voz del personaje.
- ¿Puede un modelo de vídeo sincronizar los labios con mi propia pista de audio?
- Algunos aceptan audio, pero en nuestras pruebas la entrada de audio o bien sustituía la banda sonora sin mover los labios, o bien se usaba como una referencia que el modelo volvía a interpretar. Colocar la línea exacta sobre los propios movimientos de boca del modelo dio el resultado más fiable.
Empieza tu propia serie
Describe tu mundo, crea tus personajes y planifica tu primer episodio, escena a escena.
Empezar gratis