شروح
مزامنة الشفاه في أنمي الذكاء الاصطناعي: كيف نجمع أصوات ElevenLabs مع MiniMax H3
يسجّل Animey أولًا كل جملة بصوت الشخصية نفسها من ElevenLabs، ثم يترك MiniMax H3 يحرّك اللقطة وينطق الجملة، ثم يضع الجملة المسجّلة بنصها الدقيق حيث تحركت الأفواه. فالكلمات المسموعة هي دائمًا النص المعتمد بالصوت المختار، بينما تتبع الشفاه أداءً حقيقيًا لا دبلجة مركّبة فوق الصورة.
بقلم فريق Animey5 دقائق للقراءة
الحوار هو الموضع الذي ينهار فيه أنمي الذكاء الاصطناعي أكثر من غيره: الوجه الصحيح يقول الكلمات الخطأ، أو تكون الكلمات صحيحة ويواصل الفم الحركة بعد انتهاء الجملة. يعرض هذا المقال الطرق الثلاث التي جرّبناها على جملة حوار واحدة، والطريقة التي يعتمدها Animey، استوديو أنمي بالذكاء الاصطناعي من Softforge Digital، في الحلقات المكتوبة، كما هي في أكتوبر 2026.
اللقطة والجملة
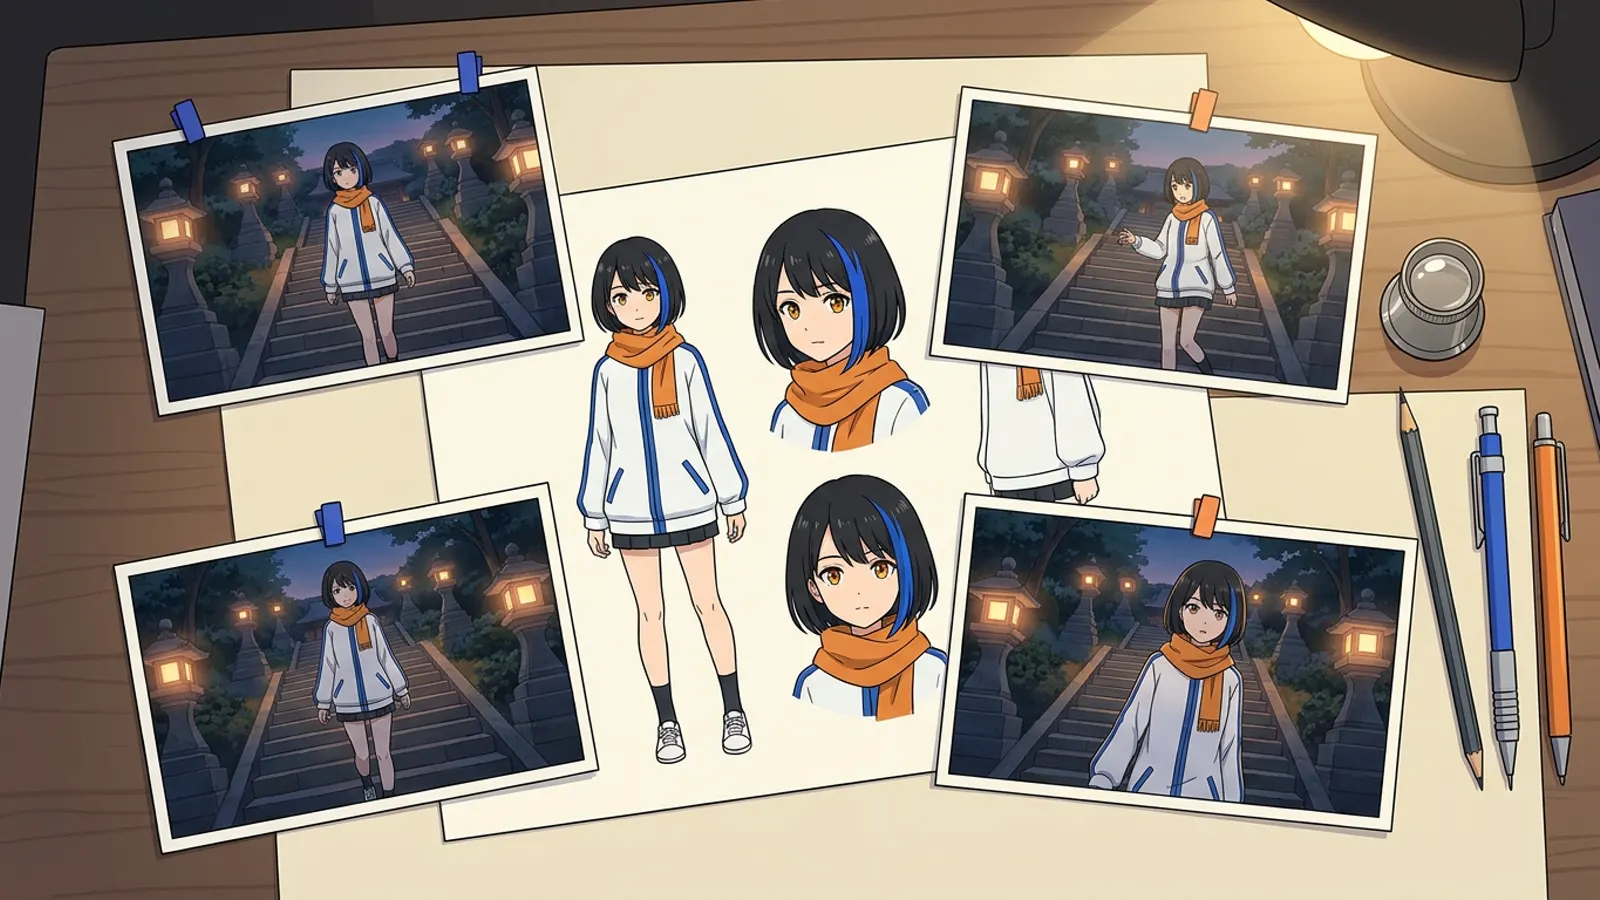
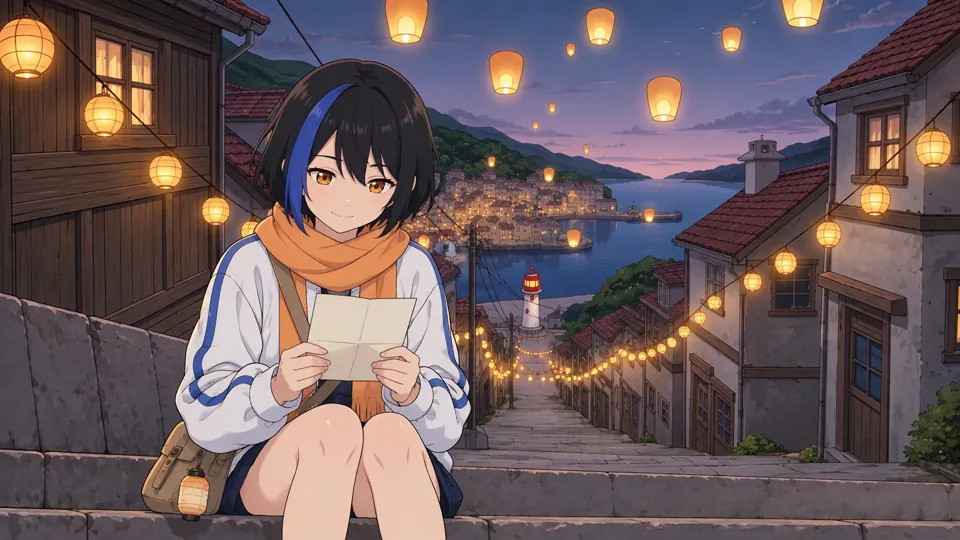
إطار مفتاحي من تجربتنا لنماذج الصور: ميرا على الدرج المضاء بالفوانيس تمسك رسالة. جملة واحدة مسجّلة بنموذج ElevenLabs Multilingual v2: «إنها من جدّي… لقد تذكّر.» تدوم الجملة المسجّلة 2.5 ثانية، وتدوم اللقطة 5 ثوانٍ.
المحاولة 1: نموذج الفيديو يتكلم من تلقاء نفسه
يستطيع MiniMax H3 Max توليد الصوت مع الصورة. طلبنا منه أن يقول الجملة، والجملة وحدها، على جزأين. الحركة جيدة والفم يتحرك متزامنًا مع الكلام، لأن النموذج نفسه صنع الاثنين.
المشكلة في كل ما يحيط بالشفاه. الصوت هو ما اختاره النموذج لهذا المقطع، فقد تبدو اللقطة التالية بصوت شخص آخر. ولا شيء يضمن الكلمات: في النسخة التجريبية قالت إحدى المحاولات جملتها ثم واصلت بكلمات مختلَقة. في مقطع واحد يبدو ذلك طريفًا، أما في مسلسل فيهدم الشخصية.
المحاولة 2: الجملة بنصها الدقيق على الأفواه
الحل البديهي أن نعطي نموذج الفيديو تسجيلنا الصوتي ليحرّك الشفاه عليه. جرّبنا ذلك، فلم يفعل مدخل الصوت في النموذج الذي نستخدمه سوى استبدال شريط الصوت: بقيت الأفواه تتحرك وفق النص، واستمرت بعد انتهاء الجملة. لذلك يعمل Animey بالعكس، في وضع نسميه النص الصارم.
- سجّل كل جملة أولًا. قبل تحريك أي شيء، تُسجَّل كل جملة بالصوت المختار للمتكلم بلغة الحلقة، من مكتبتنا أو مصمَّمًا من وصف. لا يستنسخ Animey أي صوت حقيقي أبدًا.
- دع النموذج يتكلم داخل نوافذ زمنية. يحرّك MiniMax H3 اللقطة انطلاقًا من الإطار المفتاحي المعتمد، وينطق كل جملة داخل النافذة الزمنية التي تحتاجها الجملة المسجّلة، فتنفتح الأفواه حيث ستكون الكلمات.
- حدّد الأفواه وضع الجملة بنصها. يُفرَّغ أداء النموذج نصيًا. توضع كل جملة مسجّلة بنصها الدقيق حيث نطقتها أفواهها، وتُشغَّل بسرعة بين 0.8 و1.25 ضعفًا لتملأ تلك المدة، ويُستبعد صوت النموذج نفسه.
- استخرج الترجمة من النص. الترجمة المكتوبة هي النص نفسه، موقّتة على الكلمات المسجّلة، فلا يمكن أن تخالف ما يُسمع أبدًا.
الضمان بسيط: في محاولة النص الصارم، الكلمات التي تسمعها هي النص المعتمد بصوت الشخصية، بالترتيب، دون أي إضافة. وإن حرّك النموذج فمه بكلمة ليست في النص، بقي ذلك الفم صامتًا بدل أن يقول شيئًا جديدًا.
المحاولة 3: الصوت مرجعًا
تقبل بعض النماذج الصوت مرجعًا لا شريطًا صوتيًا. يقبل Seedance 2.0 الصور والفيديو والصوت معًا، وكان مستوانا المرجعي السابق يرسل إليه الإطار المفتاحي وزوايا الشخصية والجملة المسجّلة. هذه هي الوصفة نفسها مع Seedance 2.0 Fast.
| الطريقة | الكلمات بدقة | الصوت نفسه في كل لقطة | الشفاه تتبع الكلام |
|---|---|---|---|
| النموذج يتكلم من تلقاء نفسه | غير مضمونة | لا | نعم |
| الجملة بنصها على أفواه النموذج (النص الصارم) | نعم | نعم | نعم، بسرعة بين 0.8 و1.25 ضعفًا |
| الصوت مرجعًا | غير مضمونة | قريب لكن غير مطابق | نعم |
حين يكون صوت النموذج نفسه مرحّبًا به
يفضّل بعض المؤلفين أداء النموذج: الأنفاس والضحكات والأجواء تأتي معه. هذا هو الأداء الأصلي. تُفرَّغ كل محاولة نصيًا وتُقارن بالنص، والمحاولة التي تضيف كلمات أو تُسقطها أو تغيّر ترتيبها توسم بعدم المطابقة ولا يمكن اختيارها. وإن قالت كل كلمات النص ثم واصلت الكلام، أمكن إسكات الكلام الزائد مجانًا اعتمادًا على توقيتات كلمات المحاولة نفسها.
الأصوات نفسها مشروحة في كيف تمنح شخصيتك صوتًا، وعدد الكلمات التي تتسع لها لقطة من خمس ثوانٍ في دليل الإيقاع.
أسئلة يجيب عنها المقال
- كيف تُضبط مزامنة الشفاه لحوار أنمي الذكاء الاصطناعي؟
- يسجّل Animey الجملة أولًا، ويترك MiniMax H3 يحرّك اللقطة ويتكلم داخل النافذة الزمنية للجملة، ثم يفرّغ نصيًا المواضع التي نطقت فيها الأفواه، ويضع هناك الجملة المسجّلة بنصها الدقيق بسرعة بين 0.8 و1.25 ضعفًا، مستبعدًا صوت النموذج نفسه.
- ما نموذج الصوت الذي يستخدمه Animey؟
- ElevenLabs. تستخدم الشخصيات أصواتًا من مكتبة منتقاة من أصوات الذكاء الاصطناعي المرخّصة أو أصواتًا مصمَّمة من وصف مكتوب؛ النموذج الافتراضي هو Multilingual v2، ويتولى Eleven v3 اللهجات العربية. لا يستنسخ Animey صوت أي شخص حقيقي أبدًا.
- لماذا لا نترك نموذج الفيديو ينطق الحوار؟
- يمكنك ذلك في الأداء الأصلي، لكن النموذج يختار صوته الخاص في كل مقطع وقد يغيّر الكلمات أو يضيف إليها. يطابق Animey كل محاولة أصلية مع النص، ويضمن النص الصارم الكلمات بدقة بصوت الشخصية.
- هل يستطيع نموذج فيديو مزامنة الشفاه مع مساري الصوتي الخاص؟
- بعض النماذج تقبل الصوت، لكن مدخل الصوت في تجاربنا إما استبدل شريط الصوت دون تحريك الشفاه، وإما استُخدم مرجعًا أعاد النموذج أداءه. وقد أعطى وضع الجملة بنصها على حركات فم النموذج نفسه أكثر النتائج موثوقية.
ابدأ مسلسلك الخاص
صِف عالمك، وابتكر شخصياتك، وخطّط لحلقتك الأولى مشهدًا بمشهد.
ابدأ مجانًا